Surapprentissage de stratégie : quand le résultat semble trop beau
Tu as devant toi un backtest qui a l'air de n'avoir jamais connu de perte. La courbe monte presque sans interruption, les chiffres sont forts, et pourtant une question reste : cette stratégie a-t-elle trouvé un avantage réel, ou a-t-elle simplement été tournée jusqu'à coller au passé ? C'est exactement cette question qui se cache derrière le terme overfitting. À la fin de cet article, tu sauras ce que signifient overfitting et curve fitting, pourquoi le nombre de paramètres optimisés change le risque, et quels outils StrategyQuant X propose contre cela : cross checks, analyse multimarché, simulation Monte-Carlo, un plugin optionnel Overfit Risk Score et l'analyse après l'optimisation. À la fin, il reste aussi ouvertement dit ce que ces vérifications peuvent te montrer et ce qu'elles ne peuvent pas.
Ce que signifient overfitting et curve fitting
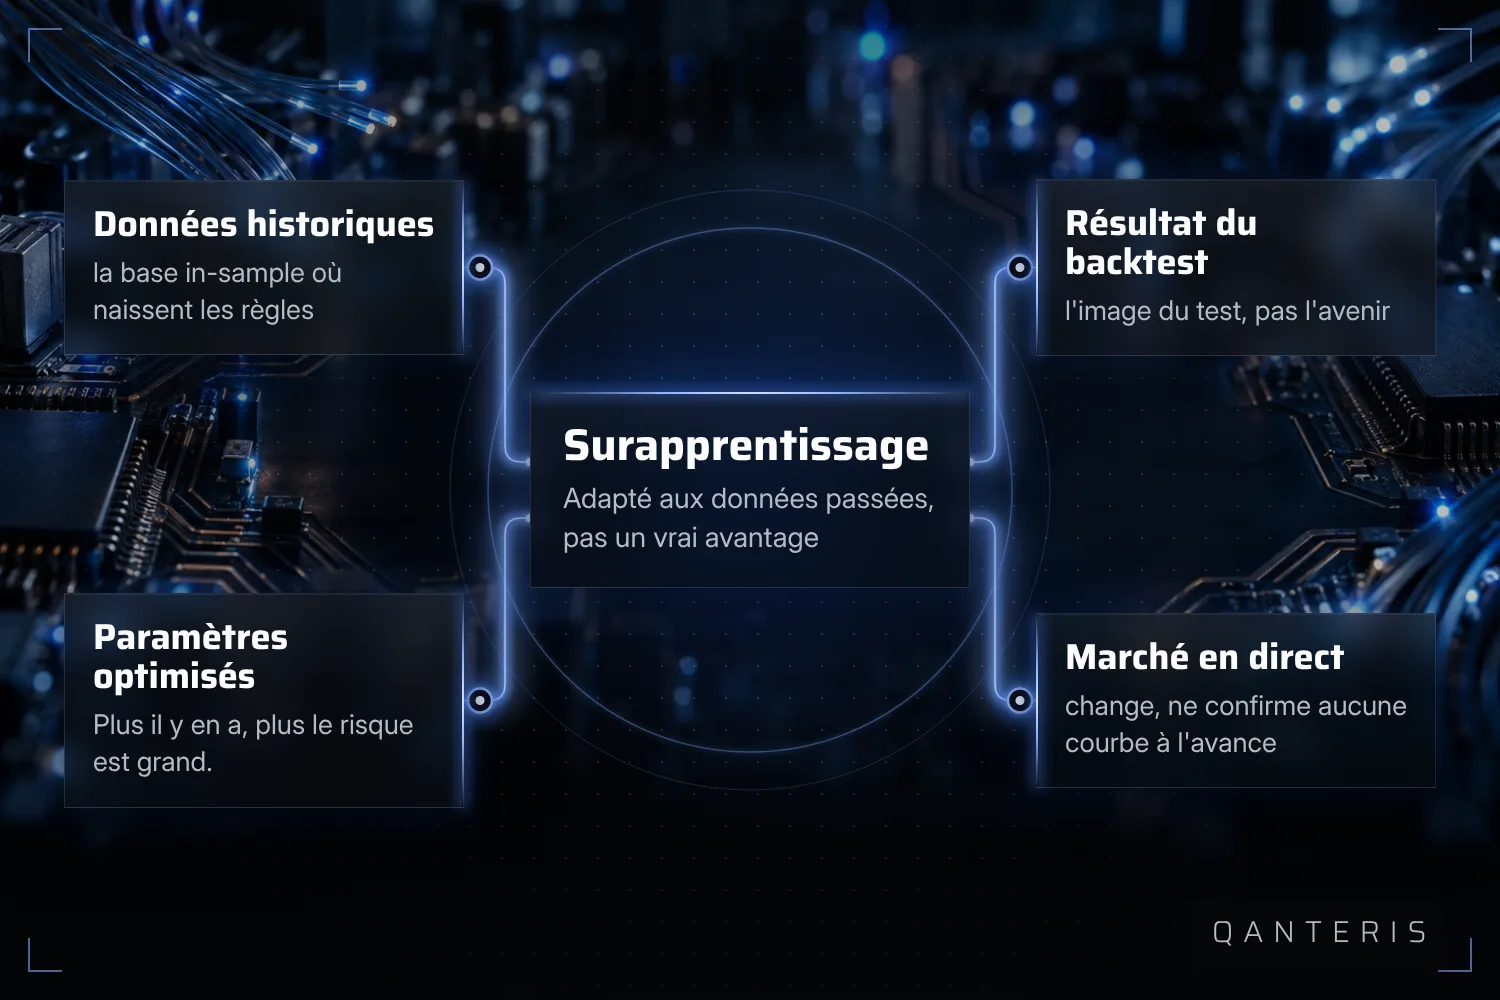
L'overfitting désigne l'adaptation d'une stratégie à exactement les données historiques sur lesquelles elle a été construite. La documentation de StrategyQuant le décrit comme le plus grand danger pour les stratégies construites avec des méthodes de génération dans le style de l'apprentissage automatique. Cela ne veut pas dire que les stratégies construites à la main seraient automatiquement sûres, la source ne dit rien de tel, l'avertissement se rapporte explicitement à cette façon de construire.
Le curve fitting est étroitement lié et décrit qu'une stratégie est taillée sur le passé jusqu'à ce qu'elle ait l'air bonne dans le backtest, sans qu'un avantage réel doive se trouver derrière. Dans la communauté, tu entends souvent les deux termes dans la même phrase. Ils décrivent deux faces du même problème : l'adaptation à ce qui a été, au lieu de ce qui revient.
Pourquoi plus de paramètres optimisés augmentent le risque
Chaque paramètre que tu libères dans l'optimisation donne à l'algorithme une possibilité de plus de s'adapter aux particularités de ces données de cours précises. Plus il y en a d'ouverts en même temps, plus l'optimisation trouve facilement une combinaison qui colle au passé par hasard, sans qu'une logique solide se trouve derrière. La documentation retient donc : un nombre plus faible de paramètres optimisables rend une stratégie tendanciellement robuste. Cela ne veut pas dire qu'une stratégie avec peu de paramètres est automatiquement exempte d'overfitting, la preuve manque pour cela. Moins de leviers réduisent l'occasion d'overfitting, ils ne l'excluent pas.
Ce que révèle l'examen des données hors échantillon
Une baisse nette de la performance n'apparaît souvent que lorsqu'une stratégie rencontre des données nouvelles, jamais vues, donc lors du test hors échantillon. La documentation décrit cette perte de performance comme une détérioration de la stratégie et cite deux causes possibles : un surapprentissage sur les données in-sample ou des conditions de marché modifiées, auxquelles la stratégie ne peut pas s'adapter. Un moins bon résultat au test hors échantillon est un indice, pas une preuve. Tu ne peux pas en déduire automatiquement que le surapprentissage en était la cause, le marché a peut-être simplement changé entre-temps. Pour toi en tant que trader, cela signifie : un résultat hors échantillon décevant est une raison de regarder de plus près, pas un jugement automatique. Et même une stratégie qui réussit cette comparaison n'a été testée que sur des données passées. Aucun de ces tests ne te dit à l'avance comment la stratégie se comportera dans de vraies conditions de marché futures.
StrategyQuant X propose plusieurs outils pour cela. Le mieux est de les comprendre comme différents angles de vue sur la même question, pas comme un outil unique qui te donnerait un jugement définitif.
Cross Checks : le contrôle de robustesse intégré
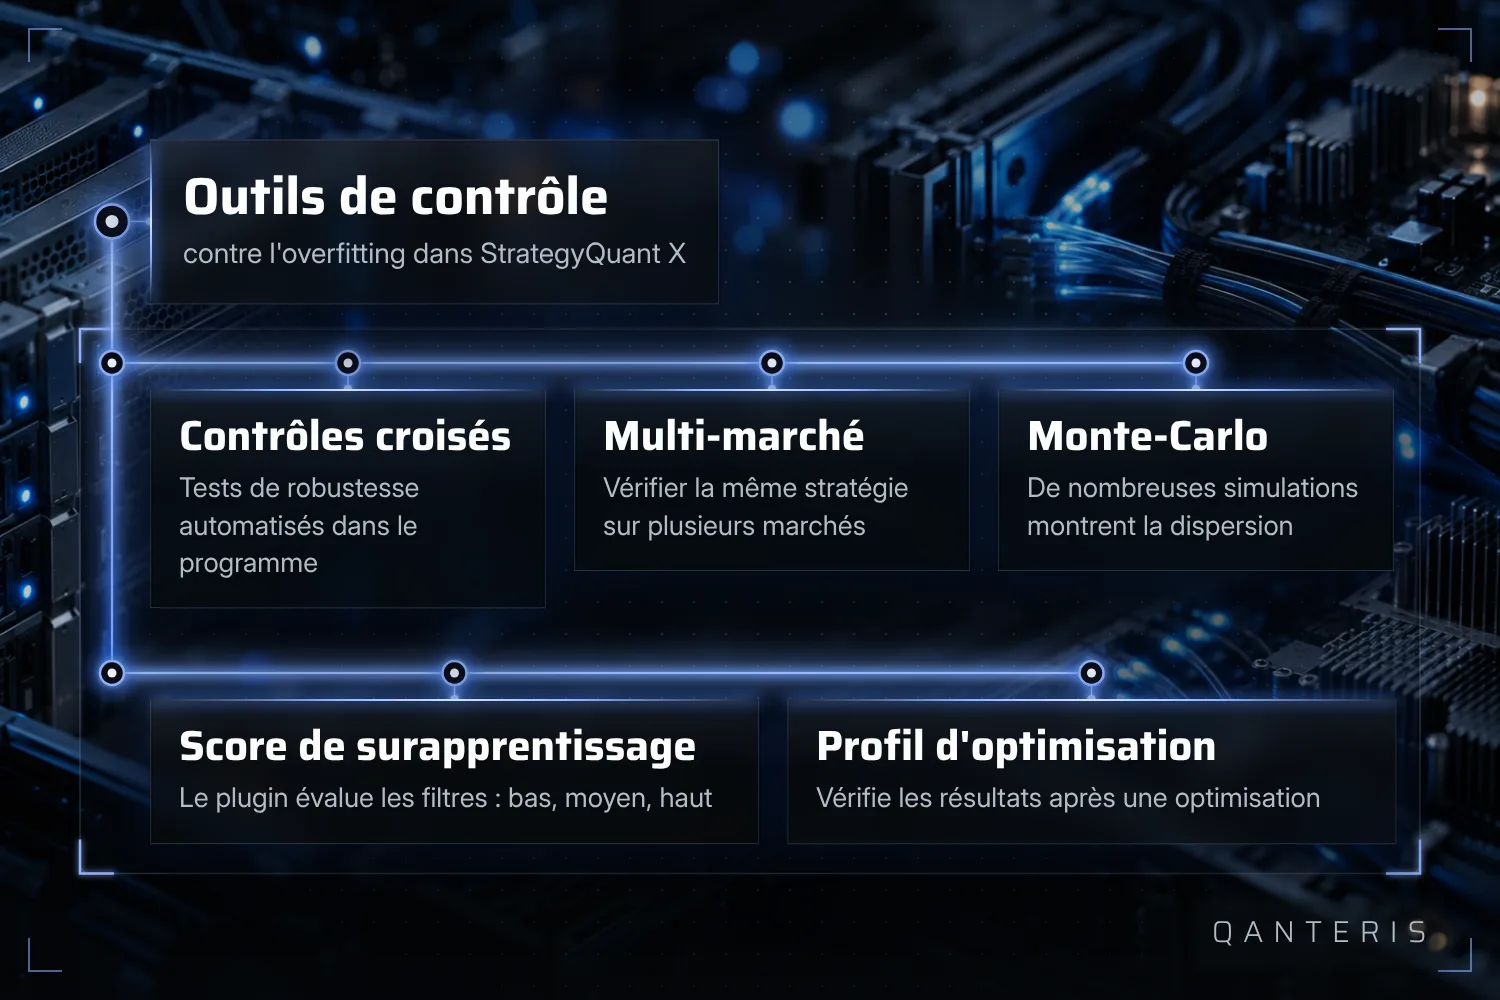
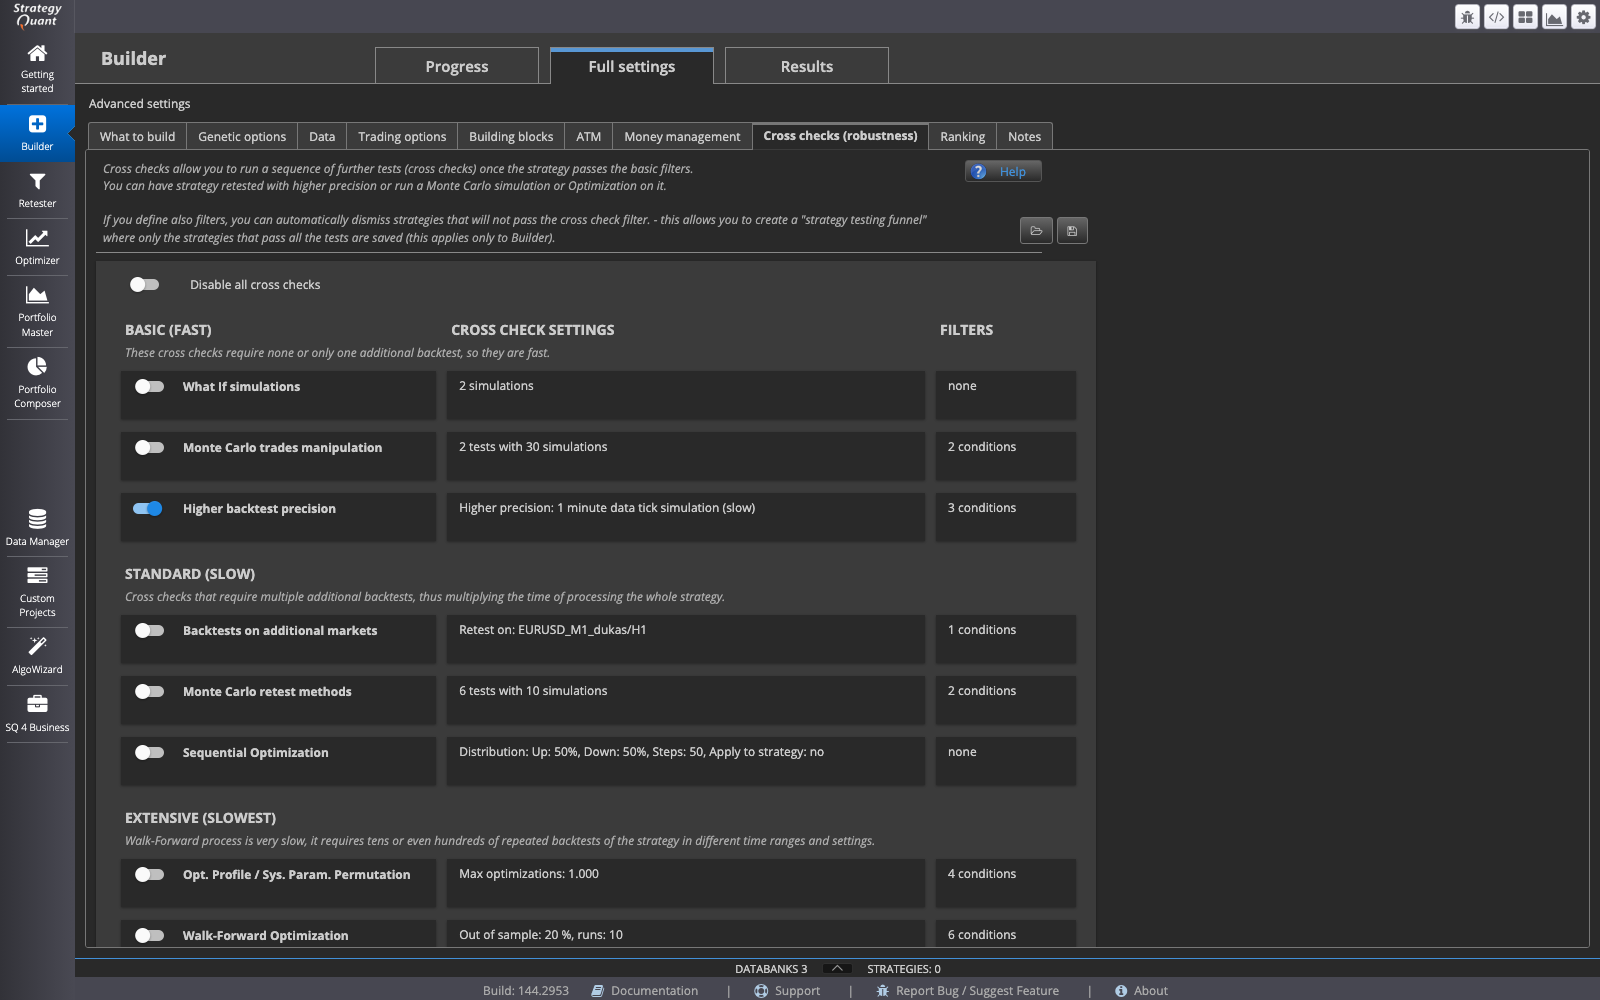
Les Cross Checks sont décrits dans la documentation comme une partie fixe de StrategyQuant X. Les tests de robustesse et la protection contre l'overfitting doivent aider à vérifier qu'une stratégie présente un avantage réel et pas seulement une bonne apparence. C'est la description du fabricant concernant le but de l'outil, pas une mesure indépendante sur une stratégie concrète. L'outil te montre quelque chose, il ne tranche pas la question à ta place.
Plusieurs marchés comme épreuve supplémentaire
Une autre vérification tirée de la documentation consiste à regarder si une stratégie générée fonctionne aussi sur plusieurs marchés, et pas seulement sur celui pour lequel elle a été construite. C'est l'une des voies décrites pour exclure l'overfitting lors de l'analyse de stratégie dans StrategyQuant X. Pour cela, tu mets en place des marchés supplémentaires et tu suis le workflow multimarché décrit avec des median-snippets dans la databank. Là aussi, la règle vaut : un contrôle multimarché réussi ne prouve pas que la stratégie est exempte d'overfitting. C'est une épreuve supplémentaire dans d'autres conditions, rien de plus.
Simulation Monte-Carlo : beaucoup de passages, un regard sur la dispersion
L'analyse Monte-Carlo dans StrategyQuant repose sur la répétition de la même simulation un grand nombre de fois avec de petites modifications aléatoires. La documentation indique : plus tu lances de répétitions, plus la distribution statistique qui en résulte devient fiable. Important ici : cette méthode travaille avec des données de trades passées et simulées. Elle n'est pas une prévision des résultats futurs de la stratégie, mais une image de la mesure dans laquelle le résultat passé dépend de petits hasards.
Le Overfit Risk Score pour les filtres
Un plugin décrit peut calculer un Overfit Risk Score à chaque application de filtres, avec les niveaux faible, moyen et élevé. La base, ce sont le nombre de filtres actifs, la part des trades filtrés et le fait d'utiliser ou non des filtres dits hindsight, donc des filtres taillés après coup sur des résultats déjà connus. Cet outil vient d'un auteur de l'équipe StrategyQuant, qui écrit sous une adresse d'entreprise, et compte donc comme une contribution officielle, pas comme une caractéristique centrale documentée du logiciel. Un score faible non plus ne prouve pas qu'une stratégie ne contient pas d'overfitting, il évalue seulement la logique de filtre que tu viens d'appliquer.
Mode de construction : Random Generation, Data Mining et la méthode classique
La documentation décrit Random Generation comme un mode de construction qui serait moins sensible à l'overfitting, parce que la stratégie n'est plus optimisée ni affinée après la construction. C'est ce qui est écrit dans la section sur les avantages de ce mode. Cela ne signifie pas que Random Generation exclut l'overfitting, mais seulement qu'une certaine étape manque, celle où il peut sinon apparaître.
À côté de cela, la documentation distingue une approche classique construite à la main sans Data Mining, comme lors de la construction d'une stratégie dans l'AlgoWizard, et le Data Mining, où un grand nombre de règles est testé pour trouver la stratégie avec la performance historique observée la plus élevée. Cette distinction est présentée comme un cadre, pas comme un guide étape par étape. La source ne dit pas que le Data Mining porte automatiquement plus de risque d'overfitting que la construction classique, la preuve manque pour cela.
Analyse après l'optimisation : Optimization Profile et Parameter Permutation
Optimization Profile et System Parameter Permutation supposent tous deux qu'un passage d'optimisation a d'abord été effectué. Les méthodes évaluent ensuite les résultats de tous les passages de cette optimisation. Elles ne remplacent pas le test out-of-sample, elles s'y ajoutent après et te montrent à quel point le résultat réagit à de petites modifications des paramètres.
Ce que ces vérifications montrent, et ce qu'elles ne montrent pas
Cross Checks, analyse multimarché et simulation Monte-Carlo réunis donnent une image nettement plus complète qu'un seul backtest. Il reste malgré tout une limite qu'aucune de ces vérifications ne peut lever : chacune d'elles travaille avec des données passées ou simulées. Aucune d'elles ne peut te confirmer à l'avance comment une stratégie se comportera dans de vraies conditions de marché futures. Un backtest propre, un Cross Check réussi ou une distribution Monte-Carlo stable sont des indices qui peuvent soutenir ton évaluation. Aucun d'eux n'est une preuve de résultats futurs.
La prochaine fois que tu te retrouves devant une courbe impeccable, la question vaut la peine d'être posée : combien de paramètres ont été optimisés, si la stratégie fonctionne sur plusieurs marchés, et ce que la distribution Monte-Carlo dit de la dispersion. Une seule réponse suffit rarement, plusieurs points de vue réunis plutôt.
Cet article a une visée éducative et ne constitue pas un conseil en investissement. Les résultats passés, y compris ceux des backtests, ne garantissent pas les résultats futurs. Négocier des instruments financiers comporte des risques et tu peux perdre de l'argent.
Cet article a un but éducatif et ne constitue pas un conseil en investissement. Les résultats passés ne garantissent rien pour l'avenir.
Et toi, comment fais-tu ? Raconte-le dans la communauté. Gratuit, dans ta langue.
Inscris-toi gratuitement