Overfitting strategii: czy backtest jest zbyt dobry
Masz przed sobą backtest, który wygląda, jakby nigdy nie poznał straty. Krzywa rośnie niemal bez przerwy, wskaźniki są mocne, a mimo to zostaje pytanie: czy ta strategia znalazła prawdziwą przewagę, czy była po prostu kręcona tak długo, aż pasuje do przeszłości? Dokładnie to pytanie stoi za pojęciem overfittingu. Po przeczytaniu tego artykułu będziesz wiedzieć, co oznaczają overfitting i curve fitting, dlaczego liczba optymalizowanych parametrów zmienia ryzyko i jakie narzędzia oferuje przeciw temu StrategyQuant X: cross checki, analiza multimarket, symulacja Monte Carlo, opcjonalna wtyczka Overfit Risk Score oraz analiza po optymalizacji. Na końcu też otwarcie stoi, co te sprawdzenia mogą ci pokazać, a czego nie.
Co oznaczają overfitting i curve fitting
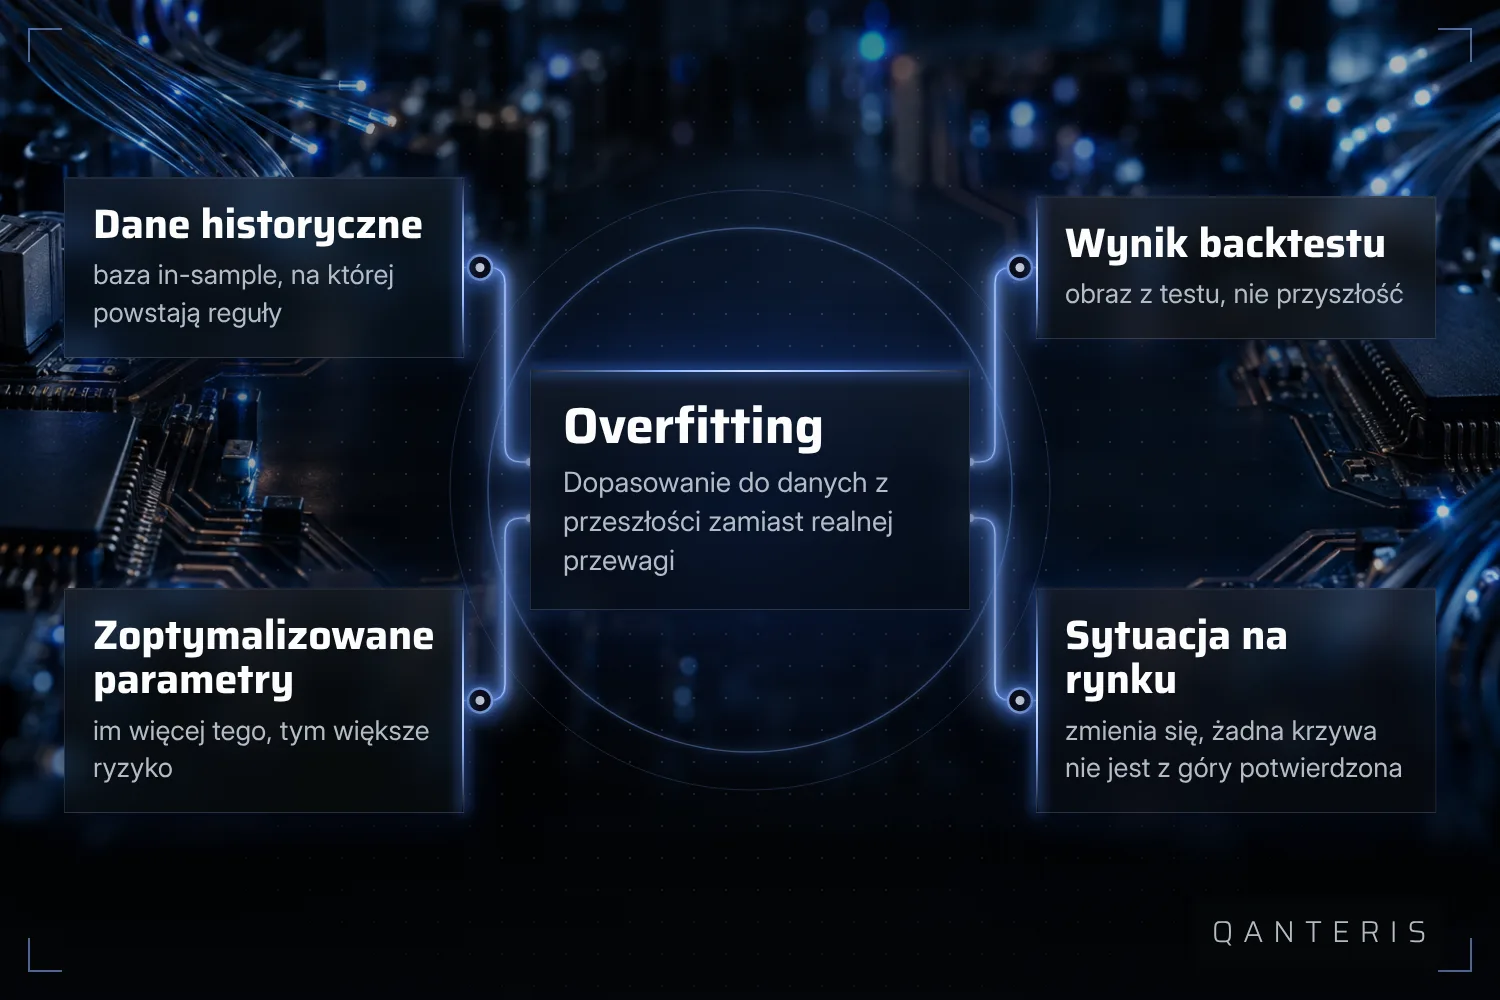
Overfitting oznacza dopasowanie strategii do dokładnie tych danych historycznych, na których została zbudowana. Dokumentacja StrategyQuant opisuje go jako największe zagrożenie przy strategiach budowanych metodami generowania w stylu uczenia maszynowego. To nie znaczy, że strategie budowane ręcznie byłyby automatycznie bezpieczne, źródło nie mówi na ten temat nic, ostrzeżenie odnosi się wyraźnie do tego sposobu budowania.
Curve fitting jest blisko spokrewniony i opisuje, że strategia jest przycinana do przeszłości tak długo, aż w backteście wygląda dobrze, bez konieczności stania za tym prawdziwej przewagi. W społeczności słyszysz oba terminy często jednym tchem. Opisują dwie strony tego samego problemu: dopasowanie do tego, co było, zamiast do tego, co wraca.
Dlaczego więcej optymalizowanych parametrów zwiększa ryzyko
Każdy parametr, który odblokujesz w przebiegu optymalizacji, daje algorytmowi kolejną możliwość dopasowania się do osobliwości dokładnie tych danych kursowych. Im więcej z nich jest otwartych jednocześnie, tym łatwiej optymalizacja znajduje kombinację, która przypadkowo pasuje do przeszłości, bez stojącej za tym nośnej logiki. Dlatego dokumentacja stwierdza: mniejsza liczba parametrów poddawanych optymalizacji czyni strategię z reguły bardziej odporną. To nie znaczy, że strategia z niewieloma parametrami jest automatycznie wolna od overfittingu, brak na to dowodu. Mniej śrub zmniejsza okazję do overfittingu, nie wyklucza go.
Co pokazuje spojrzenie na dane out-of-sample
Wyraźny spadek wyników często widać dopiero wtedy, gdy strategia trafia na nowe, niewidziane wcześniej dane, czyli w teście out-of-sample. Dokumentacja opisuje ten spadek wyników jako deteriorację strategii i podaje dwie możliwe przyczyny: overfitting do danych in-sample albo zmienione warunki rynkowe, do których strategia nie potrafi się dostosować. Gorszy wynik w teście out-of-sample to wskazówka, nie dowód. Nie możesz z tego automatycznie wnioskować, że przyczyną był overfitting, rynek mógł się w międzyczasie po prostu zmienić. Dla ciebie jako tradera oznacza to: rozczarowujący wynik out-of-sample to powód, żeby przyjrzeć się bliżej, a nie automatyczny wyrok. I nawet strategia, która przejdzie to porównanie, została przez to sprawdzona tylko na danych z przeszłości. Żadne z tych sprawdzeń nie mówi ci z góry, jak strategia zachowa się w rzeczywistych, przyszłych warunkach rynkowych.
StrategyQuant X oferuje do tego kilka narzędzi. Najlepiej rozumiej je jako różne punkty widzenia na to samo pytanie, a nie jako jedno narzędzie, które da ci ostateczny wyrok.
Cross Checks: wbudowana kontrola odporności
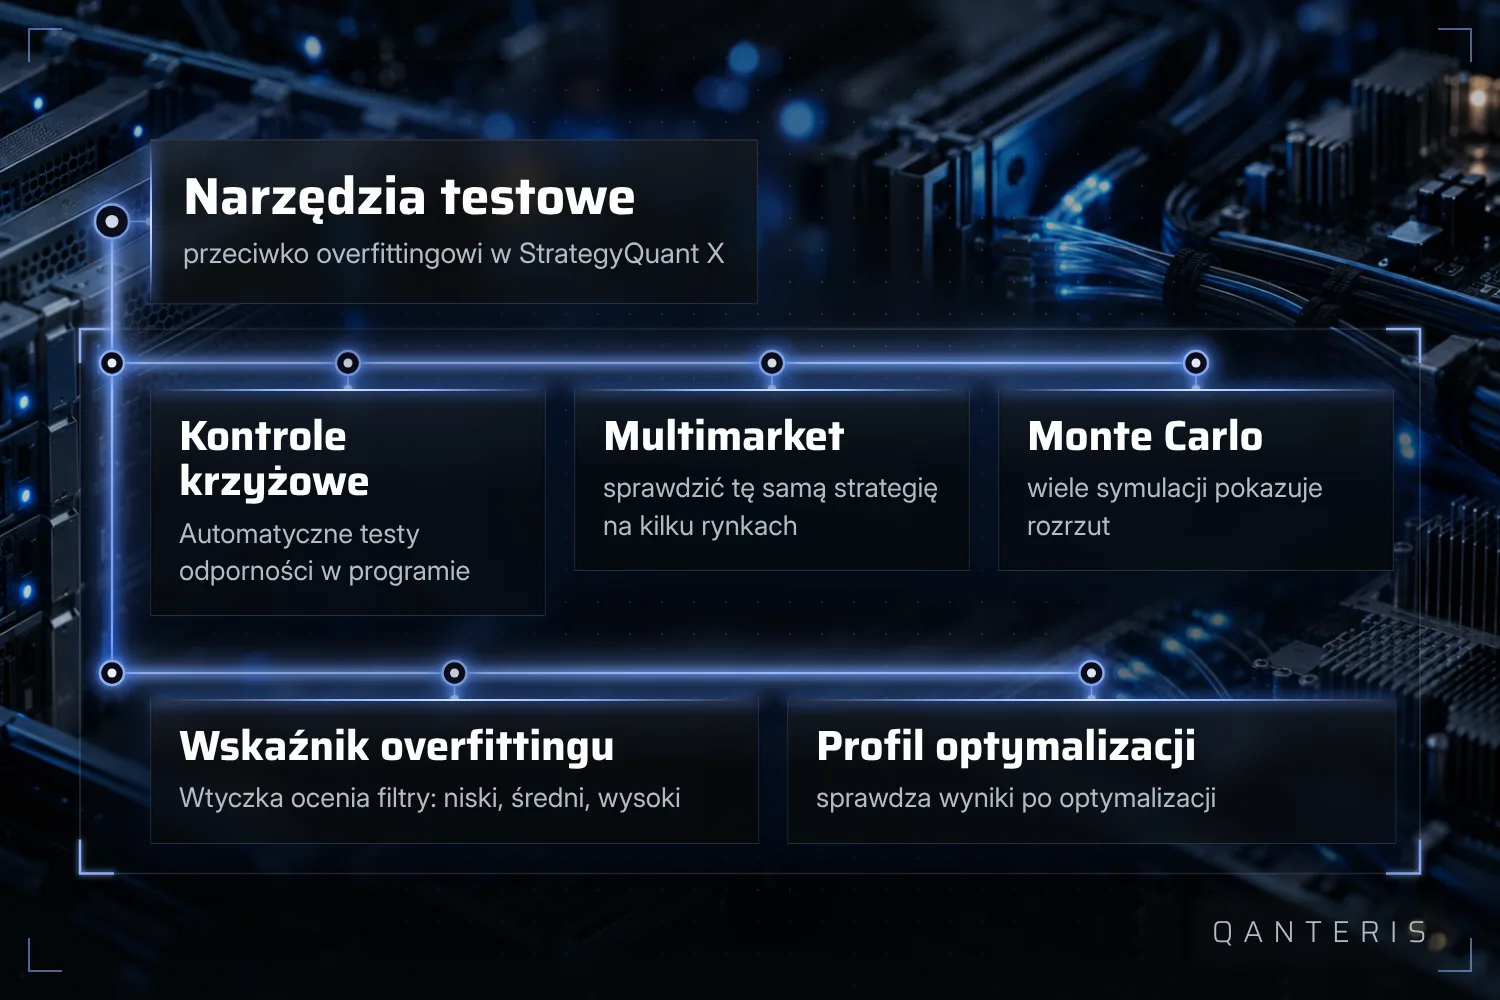
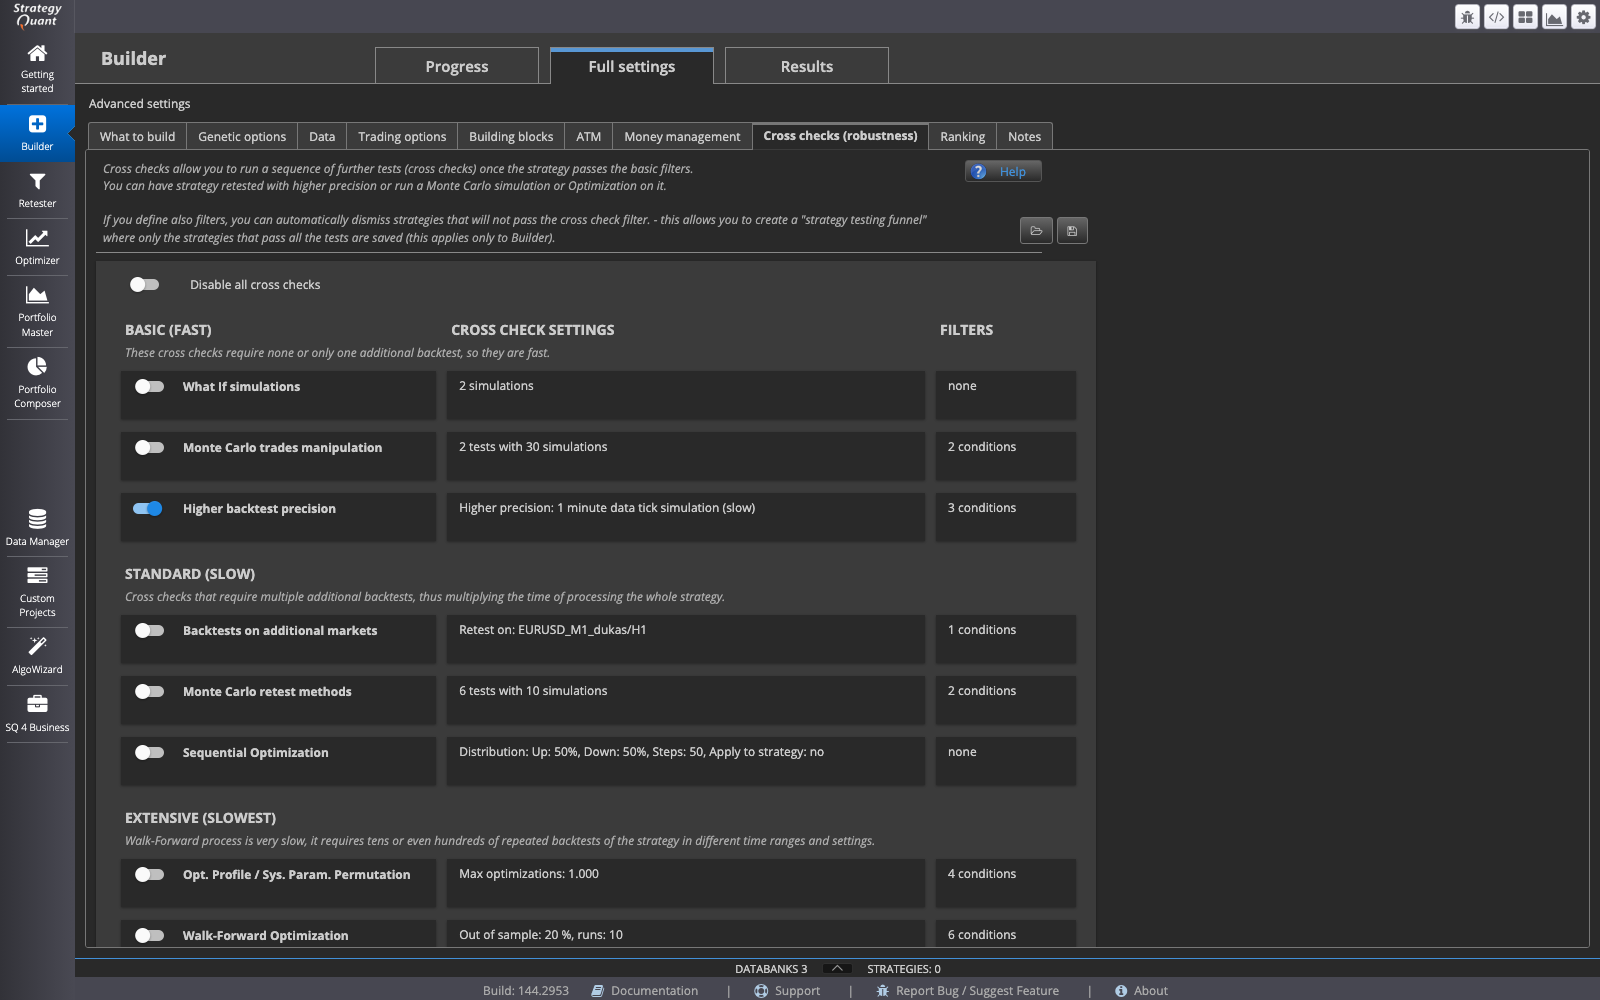
Cross Checks są w dokumentacji opisane jako stały element StrategyQuant X. Testy odporności i zabezpieczenie przed overfittingiem mają pomóc upewnić się, że strategia ma prawdziwą przewagę, a nie tylko dobrze wygląda. To opis producenta dotyczący celu narzędzia, a nie niezależny pomiar na konkretnej strategii. Narzędzie coś ci pokazuje, ale nie rozstrzyga tej kwestii za ciebie.
Więcej rynków jako dodatkowy test
Kolejnym sprawdzeniem z dokumentacji jest sprawdzenie, czy wygenerowana strategia działa także na kilku rynkach, nie tylko na tym, dla którego została zbudowana. To jeden z opisanych sposobów na wykluczenie overfittingu w analizie strategii w StrategyQuant X. W tym celu ustawiasz dodatkowe rynki i postępujesz zgodnie z opisanym workflowem multimarket z medianowymi snippetami w databank. Tutaj też obowiązuje zasada: zdany multimarket check nie dowodzi, że strategia jest wolna od overfittingu. To dodatkowy test w innych warunkach, nic więcej.
Symulacja Monte Carlo: wiele przebiegów, jedno spojrzenie na rozrzut
Analiza Monte Carlo w StrategyQuant opiera się na powtarzaniu tej samej symulacji wiele razy z małymi losowymi zmianami. Dokumentacja stwierdza: im więcej powtórzeń uruchomisz, tym bardziej wiarygodny staje się powstający z tego rozkład statystyczny. Co ważne: ta metoda pracuje na przeszłych, symulowanych danych transakcyjnych. Nie jest przewidywaniem przyszłych wyników strategii, tylko obrazem tego, jak mocno przeszły wynik zależy od małych przypadków.
Overfit Risk Score dla filtrów
Opisany plugin może przy każdym zastosowaniu filtrów obliczyć Overfit Risk Score, z poziomami niskim, średnim i wysokim. Podstawą są liczba aktywnych filtrów, udział odfiltrowanych transakcji oraz to, czy używane są tak zwane filtry hindsight, czyli filtry dopasowane ex post do już znanych wyników. To narzędzie pochodzi od autora z zespołu StrategyQuant, który pisze pod adresem firmowym, i uchodzi za oficjalny wkład, a nie za udokumentowaną podstawową cechę oprogramowania. Nawet niski score nie dowodzi, że strategia nie zawiera overfittingu, ocenia tylko logikę filtrów, którą właśnie zastosowałeś.
Sposób budowy: Random Generation, Data Mining i metoda klasyczna
Dokumentacja opisuje Random Generation jako tryb budowy, który ma być mniej podatny na overfitting, ponieważ strategia po zbudowaniu nie jest dalej optymalizowana ani dopracowywana. Tak jest to napisane w sekcji o zaletach tego trybu. To nie znaczy, że Random Generation wyklucza overfitting, tylko że brakuje jednego konkretnego kroku, w którym w innym wypadku może on powstać.
Obok tego dokumentacja odróżnia klasyczne, ręcznie budowane podejście bez Data Mining, jak przy budowie strategii w AlgoWizard, od Data Mining, w którym testuje się dużą liczbę reguł, żeby znaleźć strategię o najwyższej zaobserwowanej historycznej skuteczności. To rozróżnienie jest pomyślane jako rama, nie jako instrukcja krok po kroku. Źródło nie mówi, że Data Mining automatycznie niesie ze sobą większe ryzyko overfittingu niż klasyczny sposób budowy, brakuje na to dowodu.
Analiza po optymalizacji: Optimization Profile i Parameter Permutation
Optimization Profile i System Parameter Permutation zakładają oba, że najpierw przeprowadzono przebieg optymalizacji. Metody oceniają następnie wyniki wszystkich przebiegów tej optymalizacji. Nie zastępują testu out-of-sample, dochodzą po nim i pokazują, jak wrażliwy jest wynik na małe zmiany parametrów.
Co pokazują te sprawdzenia, a czego nie pokazują
Cross Checks, analiza multimarket i symulacja Monte Carlo razem dają znacznie pełniejszy obraz niż pojedynczy backtest. Mimo to pozostaje granica, której żadne z tych sprawdzeń nie może znieść: każde z nich pracuje na przeszłych lub symulowanych danych. Żadne z nich nie może potwierdzić z góry, jak strategia zachowa się w prawdziwych, przyszłych warunkach rynkowych. Czysty backtest, zdany Cross Check czy stabilny rozkład Monte Carlo to oznaki, które mogą wesprzeć twoją ocenę. Dowodem na przyszłe wyniki nie jest żadna z nich.
Kiedy następnym razem usiądziesz przed nieskazitelną krzywą, warto zadać pytanie, ile parametrów zostało zoptymalizowanych, czy strategia działa na kilku rynkach i co rozkład Monte Carlo mówi o rozrzucie. Jedna odpowiedź rzadko wystarcza, kilka perspektyw razem już prędzej.
Ten artykuł ma charakter edukacyjny i nie stanowi porady inwestycyjnej. Wyniki historyczne, także z backtestów, nie gwarantują przyszłych wyników. Handel instrumentami finansowymi wiąże się z ryzykiem i możesz stracić pieniądze.
Ten artykuł ma charakter edukacyjny i nie jest doradztwem inwestycyjnym. Wyniki osiągnięte w przeszłości nie gwarantują przyszłych wyników.
A jak ty to robisz? Opowiedz w społeczności. Za darmo, w twoim języku.
Zarejestruj się za darmo